正規分布は統計学で重要な存在だが,「正規分布が何を意味しているのか」という話は, ほとんどの教科書に書いていない. 統計学や機械学習の教科書の多くでは, 序盤のほうで「誤差項を正規分布とする」などと, 理由を示さずに線形回帰モデルを導入している. 教科書以外に目を向けると, 「テストの点数」とか「身長」とかが正規分布だという者もいる. 本当だろうか, なぜテストの点数や身長が同じ分布でなければならないのか, なぜ正規分布が適切なのか, といったことを疑問に感じたことはないだろうか. あまり分かってない人向けに一言で言うと「正規分布は観測誤差の発生確率という現実の現象を表すために作られた」という話をする. いろいろ分かってる人向けに一言で言うと「ガウスの誤差関数の導出過程から正規分布が何を意味しているのかを説明する」ということになる. 古典的な話題なので, 少し古い教科書を当たればもっとうまい説明が見つかりそうな気がするが, 今は過去の文献を余り調べずに書いた. 例えば二項分布とポアソン分布とはどんな分布かと聞かれたら, それぞれ「複数回コイントスしたときに表が何回出るかを表す確率分布」と, 「プロイセン軍の兵士が馬に蹴られて死ぬ確率」という有名な具体例を提示している. 後者で納得できるのかは知らないが…. 場合の数を高校数学で習うから, その知識から二項分布への接続がしやすいというのもあるだろうが, このように離散分布の多くは, どういう現象を表現しようとしているのかがわかりやすい一方で, 正規分布は頻繁に使われる確率分布でありながら, こういった説明があまり見つからない. 具体例は何かとか, なぜ「釣鐘型」になるのか, と訊かれてすぐに言えるだろうか. 例えば Claude に直感的な説明をしろと言ったら, 「小さな偶然を多数足し合わせたときに必ず現れる釣鐘形。原因の詳細を忘れる分布」などと言われた. さて, みなさんはこの文を見て, 正規分布とはそういうものなのか, と納得できるだろうか. 統計学や機械学習の教科書の多くでは, 「誤差項を正規分布とする」などと, 理由を示さず書いている. 理由を書いていないだけならまだ良くて, 「正規分布は中心極限定理から導かれる」のような, 完全に逆転した無理のある説明をする人も見られる. 例えば任意の分布から特性関数を導出できたとして, その特性関数が, 正規分布なのは自明なのだろうか? 1 あるいは, 「テストの点数が正規分布になる」「身長が正規分布になる」などと紹介する人もいる. 本当なのだろうか.2 テストの点数と身長が, どういうメカニズムで正規分布になるのか, あるいはこの2者がなぜ同じ正規分布に従っているのか, 納得の行く説明を聞いたことがあるだろうか. ここでいう納得の行く説明というのは, 数学的に厳密に説明するという意味ではない. 線形回帰モデルで誤差項を正規分布とするといろいろと便利な性質があることは数学的に証明できるし, 「一定の条件を満たす確率変数の和は正規分布に収束する (中心極限定理)」といった言明も正規分布の性質に関する数学的な説明として正しいが, これらが「正規分布が何を意味するのか」という疑問に対して, 納得できる説明となるだろうか. 納得する基準というのはきっと人によって違うから, これ以降の私の文章で全員が納得できるかはわからない. だがいずれにせよ, ここでのモチベーションは, 正規分布への理解を, 純粋に数学的な記述以外の観点からひらめきを与えられないか, というものである. とは言っても, 数学を軽視するつもりはない. 数学は曖昧さを廃するために優れた道具になる. 問題の原因は, 正規分布が抽象的で, 一見すると現実の現象を表現しているように見えないことだ. しかし, 実は正規分布も具体的な現象を表現しようとして導出されたものである. 19世紀初頭にカール゠フリードリヒ゠ガウスは誤差関数 (error function) と呼ばれる関数を考案した. 誤差関数とは, 以下で定義される関数である.3 そして, 正規分布の確率密度関数は, 以下のように定義されている. 正規分布の平均・分散パラメータが
概要
はじめに
誤差関数と正規分布
,
の場合を考える. 確率密度関数は
は
となる. 関数
は偶関数だから, 定積分
を変形すれば誤差関数
と同じになる. よって誤差関数とは, 平均ゼロ, 分散
の正規分布の (累積) 確率と同じだとわかる. つまり, ガウスの考案した誤差関数は実質的に正規分布と同じである.
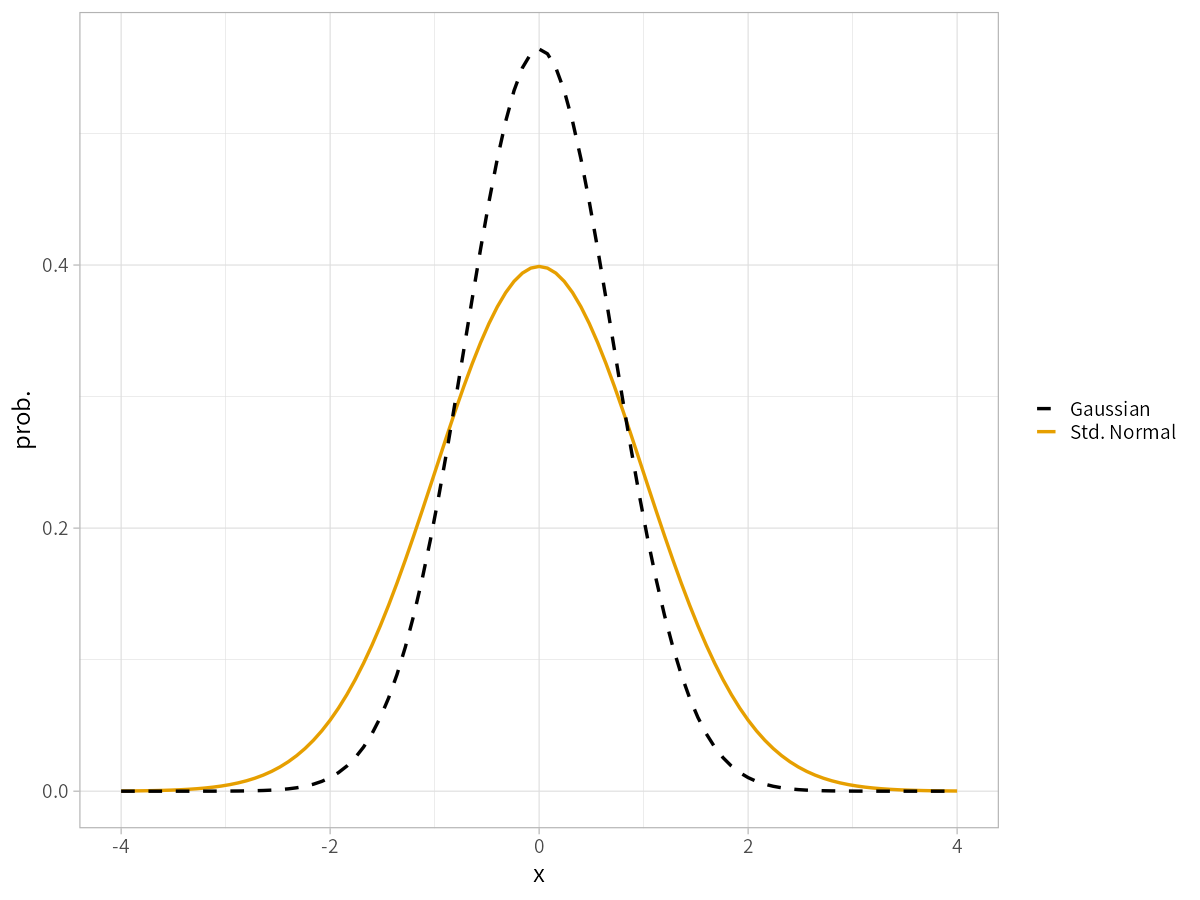
では, ガウスはこの誤差関数をどのようにして導いたのか. 1809年と1821年に発表された論文で, 彼は天体観測をする際の観測値と, 計算された理論上の位置との間に生じる誤差の分布として記述している. 当時はまだ確率の公理や現代のような統計学の理論は整備されていなかったので, 原文での記述は多少異なるが, 現代的な解釈に沿って書けば, 次のようになる.4 ガウスは正規分布を導出するにあたって, 観測に発生する誤差を特徴づけた. ただし, 以下はそのまま引用したものではなく, 私が部分的に整理したものであるが, それでも依然として数学的な意味での仮定としては, 曖昧さが残っている. まず, この差 ここで, これらをスコア方程式に代入すると, 以下のようになる. さらに, 定数 ここで, すると, 最後に残った ガウスの元の仮定で期待値をゼロにしていたから, あとは平均パラメータを追加すれば正規分布の確率密度関数と完全に同じになり, そして平均パラメータを追加しても数学的な矛盾は生じない. 以上が, ガウスの論文に則した正規分布の導出過程である. このように, 正規分布の式はどこからともなく現れたものではなく, 一定の条件の元で繰り返し観測した場合に発生する観測誤差という, 具体的な現象を表そうとして得られたものだとわかる. この意図の詳細を改めて確認する. 4つ+1の仮定と, 途中に現れた標本平均に関する言明を再掲する. 仮定 (1, 2) は単純な言明であり, (3) は, 現在の統計学で言う, 分布が独立かつ同一であることに相当する. 仮定 (4) は尤度最大化の原理を使用していることを意味する. さらに, これは, 同一の分布からの観測を何度も繰り返した時に, 微小でランダムな誤差が現れるせいで観測値に揺らぎが現れる状況とみなせる. 最後に, 以上から, 正規分布とは, 何かを繰り返し観測した際に現れる, 期待値のまわりに現れる微小なランダムな誤差を表現している確率分布である. しかしこれらにはいくつか重要な前提がある. ランダムな観測誤差とは, 例えば一様分布のように +1 と -100 の誤差が同程度の確率で発生するものでもなく, できる限り正確に観測しようと努力しており, 大きな誤差ほどより発生しにくく, そしてプラスかマイナスのどちらかに偏ったものでもない, という場面に限定している. そして, 「観測」という操作は, 実際には数式に対してほとんど制約を与えていないため, 実際には「観測」以外の様々な, 上記のような仮定をあてはめられる現象でも正規分布は現れうる. 具体的な操作を想定していながら, 最低限の仮定だけで成り立っていることが, 正規分布が広く利用できる理由ということだろう. 逆に言えば, いかに正規分布が優れていても, こういった状況にそぐわないやり方で観測されたデータに対しては, 正規分布を使っても適切な統計推論ができない可能性があるということだ. 線形回帰モデルの延長線上で言えば, GLM や GEE などがそれであろうし, 標本平均が存在すると仮定されていることに着目すれば, 裾野が広すぎて平均が発散するような分布 (そう, あの分布のことだ) に当てはめるのは適切ではない. これで,「身長」とか「テストの点数」といった現象を正規分布と紐付けた説明をどう考えればよいかがわかってくる. これらは身長やテストの点数そのものではなく, 点数や身長の平均からのばらつきが正規分布になる, と言い換えれば, ここまでの正規分布に関する性質と矛盾しない. しかしながら, 身長やテストの点数は通常正の値であり, マイナスにはならない. さらにテストの点数は100など厳密な上限があるので, ここまでに出てきた正規分布の仮定とは, 明らかに異なっている. 仮定 (2) の, 「大きな誤差が発生する確率は十分小さい」という仮定を利用して, 分散が十分小さい正規分布を近似として使う余地はあるが, 正規分布がテストの点数の分布そのものを表現していないのは明らかだ. テストの点数の分布は問題の難易度と受験者の実力の差によって決まり, 身長は栄養状態とか遺伝的要因とかで決まるものだろう. それに正規分布をあてはめたことをもって 「原理的にテストの点数や身長が正規分布に従う」と解釈するのと,「テストの点数や身長に正規分布が当てはまる」と解釈するのでは, 統計学的な意味で大きな隔たりがある. この違いを理解しなければ, 統計推論の考え方を理解できたとは言えない.10 点数の分布に正規分布を当てはめて分析することもできるし, 勉強時間とか, なにか別の変数を追加して回帰分析をすることで, 点数を説明できる要因と, それ以外の正規分布に近似できるランダムな誤差に分解することもできるのが統計学である. 追記: 物理学の一部の分野では誤差関数が現れることがあるらしいが, 私は詳しくないのでその説明はしない. 誰か詳しい人に期待しよう.
誤差関数の導出過程を追う
は, ゼロを中心として±の方向に発生し, 発生確率は対称的である
である.
, つまりゼロ誤差の確率が最大となる
は
の凹関数となる
個の理論値と観測値の差を
と表記する.
は観測値で,
は理論値である. 誤差関数はもともと, 軌道計算の際の誤差を理論化するために考案したものである. よって, 理論に基づいて計算された軌道と, 実際に観測した値である.5
は理論値と実際の値の差, つまり観測誤差といえるため, その確率は上記の (1, 2) を満たすと仮定する. 1つ1つの事象が独立したもので, その確率密度を
であると仮定する. すると,
個の観測点の同時確率は
となる. さらに, 単純化のために, 理論値が全てに対して等しい値
であるとすると,
となる. つまりここで, 母数
を推定する統計推測の問題に置き換わった. 今, 母数のとりうる全ての値が, 各観測に対して「同程度に確からしい」と仮定すれば, 観測の同時確率
が最大になるような母数が最も適切な値である. つまりこれは, 最尤推定を意味ししており, 1階条件 (スコア方程式),
を満たす
を求める必要がある. ただしここでは, 計算を簡単にするため対数尤度を最大にする条件を導出する6
である.
の形状がわからないままではこれは解けない. しかしながら, ここで直観に基づいて標本平均
を推定量として使うことを考える. この推定量が最良であることを, ガウスは厳密な証明を与えていない.7 しかし,
が正規分布だと分かっていれば, 標本平均は最尤推定量になることを, 現代の我々は知っている. ここで,
とおくと,
になる. さらに, ある
を使って
とおくと, 標本平均を以下のように変形できる.8
が対称であるという当初の仮定から,
は偶関数である. よって,
となるので,
もまた成り立つ. よって, これを上記の方程式の第2項に代入すると,
に対して関数
が
であるとき,
は定数関数でなければならない. よって, ある定数
に対して
と書ける. 元の
に戻せば, 線形微分方程式
が現れる. これを解けば,
を以下のように導出できる.
は積分定数
に対して
で与えられる.
が確率として適切なものであるには,
が必要条件になる. そこで
とおくと, これ以前にラプラスが示した
を利用できる.9 よって, 以下の確率密度関数が現れる.
を, ガウスは観測の精密さを表す尺度になるとしている. 実際この
は, 標準偏差を単純変換したものに過ぎず,
とおけば, 以下のように平均がゼロで分散が
の正規分布と同じ式になる.
結論
は, ゼロを中心として±の方向に発生し, 発生確率は対称的である
である.
, つまりゼロ誤差の確率が最大となる
は
の凹関数となる
の形が自明でない場合, 標本平均が最適であることは自明でないが, 正規分布の場合は最尤推定量となることは現代の我々であれば知っている. そして, 結果として標本平均の性質は, 正規分布の導出に必要であった.
参考文献
脚注
もっとも, さすがにまともな教科書ではそういう記述は見かけない. どこかの誰かの書いたブログとかでたまに見かける程度だ. 統計学の教科書で, 中心極限定理から導出した分布を正規分布と定義しているものを見たことがない.↩︎
結論を先に言うと, 詳しくない人にとって, こういう言い回しはミスリードなので, 私はやめたほうがよいと思っている.↩︎
ガウスの論文は, ガウス (1981) を基にした. また, 記号の用法が現代の教科書でよく見られるものとは異なるので, 現代的なものに改めて書いた.↩︎
ガウスの論文では, 軌道要素をパラメータとしたモデルによる理論値と, 赤緯の観測を念頭に置いている.↩︎
結果的に, ガウスはここで現代の最尤推定のような論を展開していた. しかし, 古い時代のことなので, その導出過程はややぎこちない. この過程にこだわることは正規分布の導出にはあまり関係ないため, ここでは現代的な対数尤度を使用した式変形を使用している.↩︎
仮定 (3) では, 大きな誤差が発生しないと書いた. つまりこれは, 期待値が発散するほど分布の裾野が厚く, 標本平均が意味をなさなくなるような状況を排除しているといえる.↩︎
不思議な式変形に見えるかもしれないが, これは標本平均が観測値列
に対して一次従属であることを利用している.↩︎
ただし, この式は現在ではガウス積分と呼ばれている. また, アイディアの原型はド゠モアヴルにあるとされている.↩︎
「テストの点数が正規分布になる」という言い方は「『偏差値』とはテストの点数を正規分布で近似できるという前提で設計された指標」という説明を, 因果関係を逆転して誤解してしまっているのではないかという気がする.↩︎
